
“告警太多了,能不能先把平台关掉?”在机房和动力环境监控项目里,这句话并不少见。值班人员一天收到几十条、几百条通知,温湿度轻微波动、设备状态切换、通信抖动和真正的故障混在一起。时间一长,人会形成告警疲劳:提示看不过来,电话不愿接,严重事件也可能被当成又一次误报。
从事动环项目和现场运维这些年,我的经验是:告警泛滥时,先别急着否定平台,也别简单把阈值调高。很多问题出在阈值没有分级、测点数据不可靠、告警没有去重,以及通知方式没有按处置时效设计。治理的目标也不是把告警数量压到最低,而是让需要人采取行动的告警及时到达正确的人,同时保留足够的信息供事后追溯。
告警多,不一定是平台没用
动环平台负责采集、判断和通知,但告警是否有用,取决于前后整条链路:测点装得是否合理,设备数据是否可信,阈值是否符合现场工况,告警是否持续到值得处理的程度,通知是否找到当班责任人,最后有没有确认和闭环。
例如,温湿度探头贴着送风口,读数可能随气流快速变化;门磁或漏水绳接点接触不稳,可能产生瞬时跳变;通信链路短时中断,也可能把一批设备同时显示为离线。如果不先查数据质量和现场安装,只调整阈值,可能压住表面上的告警,却留下真正的盲区。
因此,接手“告警太多”的现场,我通常先看三件事:告警是否对应一个明确的风险或动作;同一事件有没有被重复通知;值班人员收到后能否判断先做什么。回答不了这三件事的告警,需要重新梳理。
阈值要按风险和处置时效分级
阈值配置不是给所有测点填一个上下限。不同对象的风险不同,处置时间也不同。可以先把告警分成紧急、重要和提示三级,再分别定义触发条件、通知对象和响应要求。
| 等级 | 适用情形 | 常见处理方式 |
|---|---|---|
| 紧急 | 可能立即影响人身、设备或业务连续性,需要尽快确认和处置 | 电话、短信或值班强提醒;通知当班责任人,必要时升级 |
| 重要 | 存在明确异常,但允许在规定时限内排查处理 | 生成工单或进入运维待办,记录责任人与完成时限 |
| 提示 | 轻微偏离、趋势变化或不需即时干预的信息 | 汇总到白天巡检、日报或趋势分析中 |
温湿度轻微越限未必都要全员电话通知;可以根据机房设计要求和现场运行策略,先进入提示或重要级别,并结合持续时间、变化趋势和区域情况判断。UPS 电池、输出、旁路等关键状态异常,漏水告警,配电跳闸或关键回路失电,则通常需要按实际影响配置较高优先级。具体分级必须以设备能力、设计要求和现场应急预案为依据,不能照搬别的机房数值。
要特别留意阈值的单位、采样周期、上下限方向和测点位置。同一个温度数值,在不同区域、不同设备和不同运行策略下,含义可能不同。项目交付时应把设定值、延迟时间、死区、通知规则和责任人一起记录,避免只留一个孤立的阈值表。
误报和漏报往往出在阈值之外
误报是系统提示异常,但现场核查后并无对应故障或处置需要。常见来源包括传感器精度或安装问题、通讯抖动、瞬时尖峰、阈值过窄、告警延迟设置不当,以及设备检修期间未做告警屏蔽或维护标记。
漏报更危险:实际异常没有生成告警,或告警虽然产生却没有送达、没有被看见。原因可能是阈值设得过宽,测点缺失或失准,采集通道中断却未做通信故障告警,通知对象错误,或夜间升级规则没有覆盖。还有一种容易忽视的情况:告警已被抑制,但抑制逻辑把新的、更严重的状态也一起压掉了。
处理误报时,不应只问“要不要把阈值调高”,还要确认告警发生时的原始数据、持续时间、设备状态、环境变化和人员操作。处理漏报时,则要反向验证异常路径:从传感器到网关、平台规则、消息通道、值班确认,每一段是否都能工作。需要时通过受控的告警测试验证链路;测试要按现场安全规程执行,并明确测试状态,避免造成真实设备风险或干扰值班。
告警抑制要保留根因和关联关系
同一个点位在短时间内反复越限,通常不需要每次都重新拨电话。可以设置重复告警合并或抑制窗口:首次告警立即通知,窗口期内更新持续时间、最高/最低值和状态变化;恢复后记录恢复时间,若再次触发则作为新事件处理。窗口多长要按告警类型和风险确定,不能对所有点位统一套用。
上下游设备之间也可能存在因果关系。比如空调停机后,机房温度逐步升高,平台可能同时收到空调故障、温度越限等多条告警。可以在告警展示和通知上突出可能的根因及其关联告警,减少重复打扰。但关联不等于可以把后果告警删除:温度越限仍是独立风险信号,应保留在事件记录中,并按严重程度决定是否单独通知。
通信中断、设备停机、维护操作等状态也要分别设计。通信故障不应伪装成设备正常;维护屏蔽应有开始和结束时间、操作人和原因;紧急级别告警原则上不能被一般性的去重规则无限期压制。每条抑制规则都要能解释“压了什么、为什么压、何时恢复、如何审计”。
以通微多年的经验,告警根因的判断,关联关系,包含关系等,既需要对行业特点和业务的深刻了解,也要通过软硬件的数据流梳理,业务流的同步,告警规则的多模式适配,方能把告警抑制做好,做到精简告警,又能不漏告警。当然,边侧AI的快速发展,将会对这个事情的解决产生重要辅助。
用一周试运行验证告警质量
阈值和通知策略调整后,建议选择一个站点或一类设备先试运行一周,和客户、运维及值班人员一起复核。试运行不是单看告警数有没有下降,而是检查告警是否更可处理、重要事件是否仍能及时发现。
可以跟踪以下指标:
- 有效告警率:经核查后确实需要处理或跟踪的告警,占全部告警的比例。统计口径要提前约定,提示类信息可单独统计。
- 重复告警占比:同一事件、同一点位在设定窗口内重复生成或重复通知的比例。
- 确认与处置时间:从告警产生到值班确认、开始处理、恢复或关闭的时间。
- 漏报与迟报记录:巡检、工单或故障复盘中发现,但平台没有及时生成或送达的异常。
- 未确认告警和升级情况:是否存在责任人未确认、升级规则未触发或消息渠道失败。
试运行开始前先保留原始规则和历史样本,逐类约定目标和升级方式;期间每天抽查高等级事件和被抑制事件;结束后再调整阈值、持续时间、通知对象和抑制窗口。有效告警率可以作为沟通指标,但不能单独代表安全水平。如果告警数下降的同时漏报增加,策略就是失败的。
告警治理不是一次性“调参”。设备更换、季节变化、负荷调整、机房改造和值班制度变化,都可能让原来的规则不再合适。重要告警要定期复盘,规则要有责任人和版本记录,才能让系统跟上现场变化。
先把告警变成可行动的信息
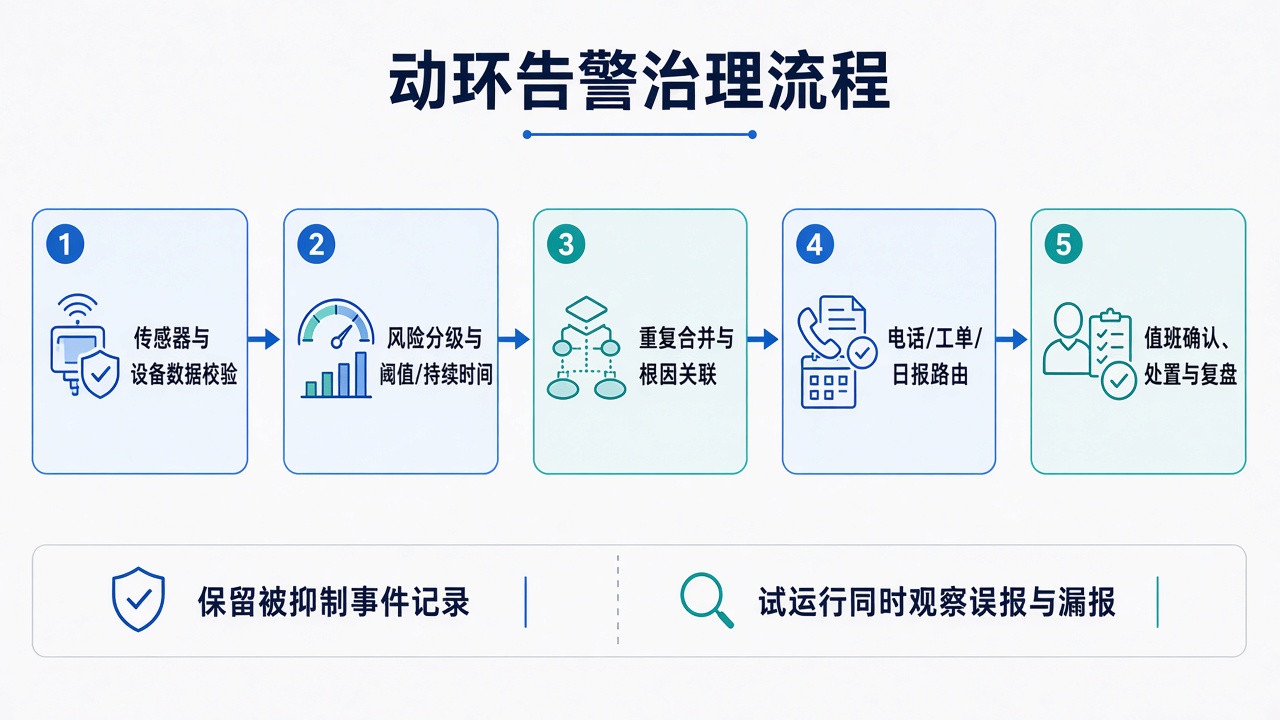
遇到“告警太多、值班不想看”的情况,不妨按这个顺序推进:先校验测点和采集质量,再按风险划分紧急、重要、提示;接着设置持续时间、死区和同点位重复合并;梳理设备关联,展示可能根因但保留相关风险信号;最后明确电话、短信、工单和日报分别由谁接收、多久确认、未响应时如何升级。
可以和客户先约定一周试运行,以有效告警率、重复告警占比、确认时长和漏报记录共同评估。比起直接关闭平台,这样更能找出告警噪声来自哪里,也能验证关键告警是否仍然可靠。平台的价值不在于把每一次波动都喊出来,而在于让值班人员在正确的时间,收到足以采取正确行动的信息。