
很多设备维护计划是按日历排的:每月巡检、每季度保养、每年更换某些耗材。这些工作有必要,但日历不会知道一台风机最近振动变大,也不知道一组 UPS 电池中的某节电压变化正在偏离同组电池。另一种常见情况是设备坏了再抢修,故障发生时才发现备件不在库、夜班人手不足,或停机影响超出预期。
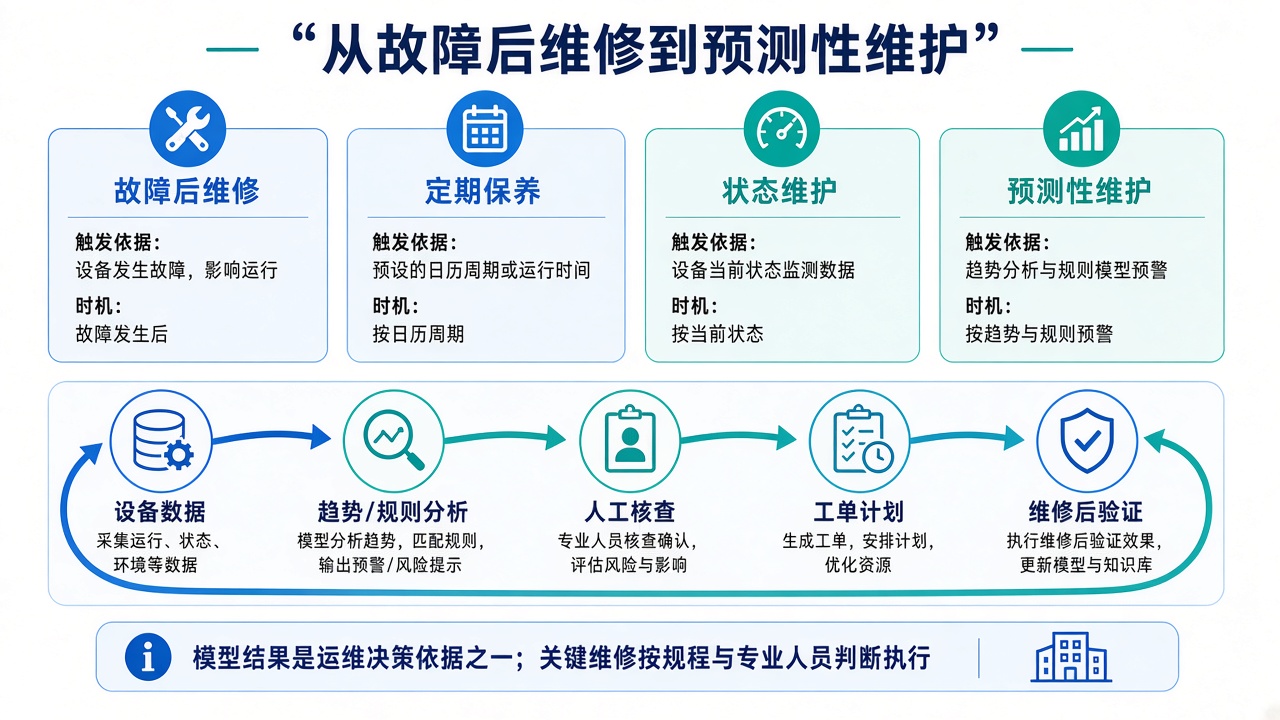
预测性维护的意义,是把维护时机从“固定日期”或“已经坏了”往前移到“状态开始退化、还有时间安排处置”。美国能源部联邦能源管理项目将状态维护与预测性维护描述为通过检测性能退化的起点,支持在设备失效或使用者察觉之前进行修正;其楼宇能管资料也举出空调过滤器压差、换热器传热变化等可监测例子。美国能源部:EMIS 能力与状态/预测性维护
从现场角度讲,预测性维护不是“装上传感器就能预测哪天坏”,而是建立一个持续改进的工作过程:采到可信数据,知道设备正常运行是什么样,及时识别偏离,安排人员确认,按风险制定工单,再检查维护是否解决了问题。
预测性维护解决什么问题
可以把运维方式简单分为三类。故障后维修是在故障发生后处理;定期预防性维护按时间、运行小时或厂家要求保养;状态维护根据设备当前状态触发检查或维修;预测性维护则利用持续趋势和诊断信息,估计退化风险或剩余处置窗口,帮助运维提前安排资源。实际项目里,状态维护与预测性维护常有交叠,名称并不如数据和工作流程是否有效重要。
对机房、楼宇和园区而言,价值主要体现在几方面:减少突发停机和临时抢修;减少对状态良好设备的过度保养;提前准备备件和人员;发现设备效率下降、控制异常造成的隐性能源浪费;把巡检重点从“每台设备都看一遍”调整为优先检查风险更高的设备。
需要把边界说清:平台发现趋势异常,并不自动等于设备即将故障。传感器漂移、负荷变化、季节工况、运行策略调整都可能造成相似表现。系统应给出信号、证据和优先级,由熟悉设备的人员复核,再决定是否检修。
动环和楼宇设备看哪些信号
UPS 与蓄电池。 可关注单体电压、组间差异、温度、充放电状态、告警历史、内阻或电导等设备支持的参数。判断应结合电池类型、厂家要求、环境温度和定期测试结果。单一参数异常适合触发复核,不能脱离规程直接推断电池必然失效。
空调与暖通设备。 可观察压缩机和风机启停频率、运行电流、供回风温度、冷冻水供回水温差、阀门开度、过滤器压差以及设备运行时长。比如过滤器压差持续上升可以提示检查堵塞;设备长时间运行但温差或制冷效果变差,可能需要检查换热、流量、传感器或控制策略。具体诊断要结合设备工况,不能把单一趋势当作确定原因。
水泵、风机和电机。 在关键设备上可结合振动、轴承温度、电流、转速、压差、流量和启停次数,观察是否出现持续变化。负荷变化会影响部分信号,因此需要同时读取运行状态和工况,避免把正常的变频调节判成故障。
配电和环境。 可结合回路电流、电压、功率因数、温升、开关状态、环境温湿度、漏水、门禁及通信状态。对有安全或业务连续性影响的对象,应优先保证测点可靠、采集连续、告警能送达,再考虑复杂模型。
现场常用的四类方法
阈值与规则。 工程师依据设备规格、运行边界和经验设定上下限、持续时间、变化率或点位之间的逻辑关系。规则透明、容易解释,适合关键告警和已有明确故障机理的对象。阈值需要考虑死区、启停状态和维护模式,否则容易产生误报。
趋势与基线比较。 对运行小时、温差、压差、电流、能耗等做时间序列比较,找出持续偏离历史基线的设备。基线需按季节、工作日/周末、负荷、室外天气和设备模式分组,否则正常工况变化可能被误判。
故障检测与诊断规则。 把多个点位和设备关系放在一起判断,例如阀门已开、风机在运行,但温度响应没有达到预期;或泵运行时压差和流量关系异常。美国能源部将自动故障检测与诊断列为能管系统能力,并指出其可帮助识别 HVAC 或关键机械系统中的故障、性能退化、控制问题和运行序列问题。美国能源部:EMIS 能力
统计或机器学习模型。 数据量和质量足够时,可建立负荷预测、异常检测、故障模式分类或剩余寿命估计模型。模型应通过历史事件和现场确认验证,定期检查漂移,并向维护人员说明主要依据。没有故障标签、设备台账和稳定运行数据时,先做数据整理和规则诊断,通常比直接上复杂模型更可靠。
从数据到工单的实施路径
第一,选设备而不是先选算法。按关键性、故障影响、维修成本、数据可得性和现有故障频率排序。先挑一类关键设备做试点,例如关键机房的 UPS 电池、冷源设备或重要泵组。
第二,补齐设备与测点基础。统一设备编码、位置、型号、维护记录、点位单位和采样间隔;核对传感器安装、校准和通讯状态。采集不到、时间戳不一致、状态标签不清的数据,不适合直接用于预测。
第三,建立基线和规则。选取正常运行周期,标记设备启停、检修、季节和负荷变化;先上线可解释的阈值、持续时间、趋势偏离和多点关系。把告警分成提示、重要、紧急,分别定义谁看、多久响应、怎么升级。
第四,让分析结果进入日常维护。诊断结果要能生成待核查任务或工单,包含设备、异常时间段、相关趋势、可能原因、建议检查项和风险等级。技术人员现场确认后记录真实原因、维修动作和结果,形成后续规则与模型可以学习的反馈。
第五,验证是否有用。试运行期间关注提前发现时间、有效告警比例、计划维修占比、非计划停机、重复报修、备件准备和维护成本。不能只看模型准确率或告警量;需要确认告警是否让团队提前采取了有效措施,也要记录误报和漏报。
先从高价值设备开始
不是每台传感器、每个风阀都值得做复杂预测。关键设备、故障后果大、维护周期长、运行数据足够的对象更适合先做。普通设备可以继续按厂家周期保养,重要设备叠加状态监测,具备数据基础后再逐步提高诊断水平。
老工程师判断一个预测性维护项目是否落地,不是看大屏上有几个 AI 图标,而是看现场有没有因为信号提前准备备件、调整检修窗口,或者避免故障扩大;工单关闭后,数据和维护记录能不能回到系统里。先把一个设备族的流程跑通,再扩到整个园区,比一开始铺开所有设备、最后无人处理更实在。